💡 Contenido previo: En nuestro análisis anterior identificamos el error de escribir lo que nos gusta en lugar de lo que buscan los clientes en internet. Una vez resuelto el enfoque de la demanda real, el siguiente paso técnico y operativo consiste en asegurar que el motor de búsqueda sea capaz de descifrar tu estructura de contenidos de manera eficiente, fluida y sin bloqueos de lectura.
Hooola 👋
Entender cómo nos ve Google es el punto de partida indispensable para cualquier negocio que busque visibilidad real en internet. Hace poco hablábamos de un cambio de mentalidad estrictamente necesario en las operaciones digitales: dejar de escribir para nuestro propio ego profesional o intereses internos y empezar a estructurar las soluciones que realmente demandan nuestros clientes en su día a día.
Sin embargo, en la arquitectura de cualquier plataforma web existe un detalle de ingeniería que no podemos ignorar bajo ningún concepto: puedes disponer del contenido de mayor autoridad técnica del mundo, pero si el robot de Google accede a tu plataforma y se siente como un turista extraviado y sin mapa, tu esfuerzo operativo no servirá absolutamente para nada.
No basta con diseñar una interfaz relevante y agradable para el ojo humano; es indispensable construir una estructura que resulte perfectamente descifrable y ordenada para la máquina.
Hoy vamos a dar un paso fundamental en nuestra Fase 3 (La Capa Digital). Vamos a entender cómo nos percibe el algoritmo en sus entrañas, sin tecnicismos complejos, sin fórmulas abstractas y sin necesidad de que aprendas a programar para lograr que el robot catalogue tu sitio web como una referencia sólida dentro de tu sector.
Índice de contenido
1. Código vs. Estética: La anatomía de la percepción del robot. Así es como nos ve Google
Cuando tú, como usuario o propietario del negocio, accedes a tu página web corporativa, visualizas un diseño cuidado, una paleta de colores elegida con detenimiento, logotipos nítidos y una selección de imágenes que transmiten la propuesta de valor de tu actividad.
Contemplas una obra visual terminada de la que te sientes plenamente satisfecho. Sin embargo, para los sistemas automatizados de Google, tu plataforma no es más que una gigantesca e ininterrumpida sábana de código fuente en formato HTML, hojas de estilo CSS y cadenas de texto plano.
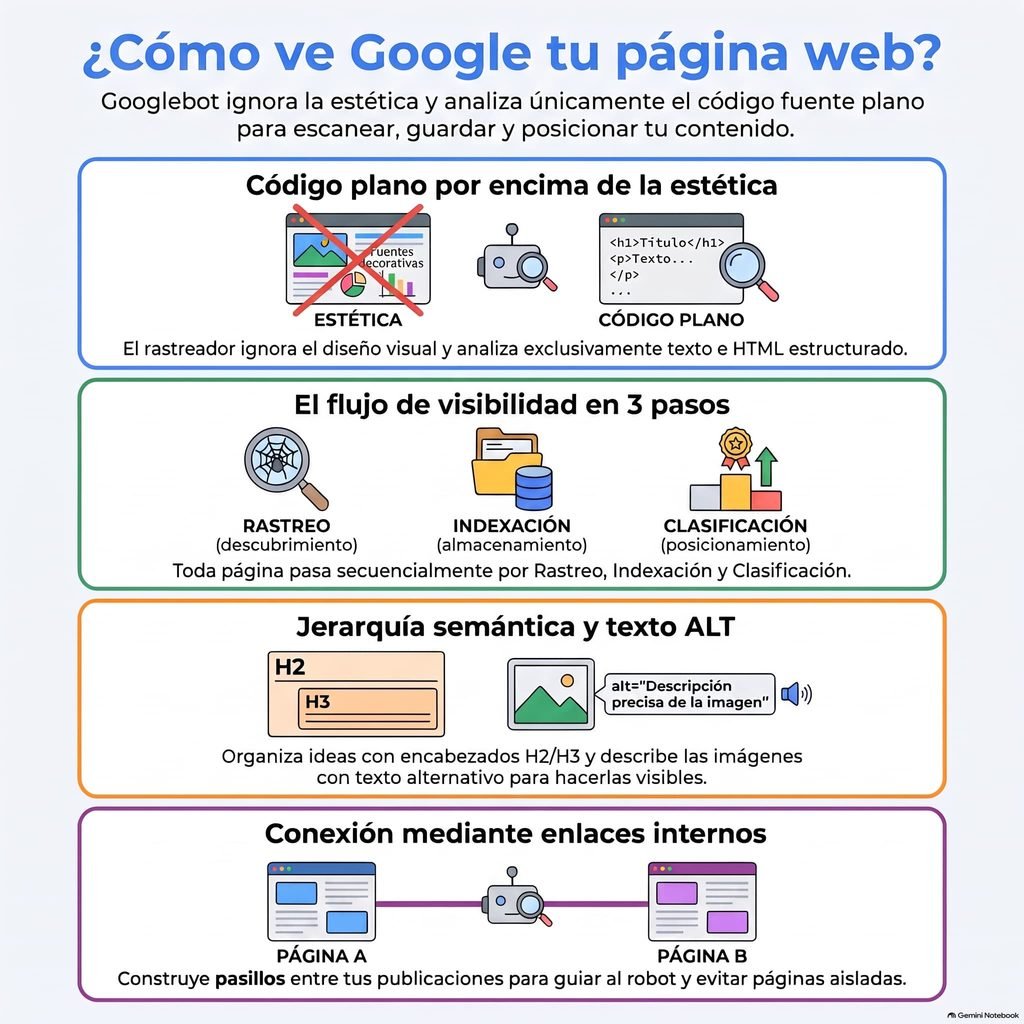
El buscador no posee receptores biológicos ni apreciación estética para valorar la simetría de un isotipo, el contraste de un degradado o el maridaje entre dos familias tipográficas. Su infraestructura técnica se apoya en programas informáticos de rastreo automatizado (Googlebot) diseñados con un propósito muy concreto: escanear, descargar y procesar miles de caracteres de texto a una velocidad vertiginosa consumiendo el mínimo de recursos de servidor.
Comprender esta divergencia radical de percepciones es la piedra angular del SEO con sentido común. Si ignoras la manera en que el robot ejecuta su lectura técnica, estarás optimizando tus canales únicamente para las personas que ya conocen tu dirección, pero permaneciendo totalmente invisible para la entidad que posee las llaves de la visibilidad orgánica: el bibliotecario del índice global.
En el diseño de sistemas de información existe un principio elemental: la forma siempre debe servir a la función. Si construyes un portal sobrecargado de elementos visuales que ocultan o entorpecen la lectura del código semántico, la máquina se encontrará con una barrera insalvable. El rastreador no invertirá tiempo en descifrar lo que un programador desordenado quiso decir; simplemente pasará de largo hacia la siguiente página de la cola de rastreo.
2. El Diagnóstico: La prueba empírica de tu existencia digital
El primer paso de cualquier diagnóstico operativo consiste en descubrir si los rastreadores automatizados han visitado tu servidor recientemente o si, por el contrario, desconocen por completo que tienes la plataforma operativa. Multitud de proyectos empresariales se estancan debido a la ausencia total de visitas cualificadas, asumiendo erróneamente un problema de competencia feroz en su nicho, cuando el diagnóstico técnico revela que el fallo es puramente de infraestructura: un problema grave de indexación primaria.
¿Cómo diagnosticamos esta situación sin usar herramientas avanzadas de desarrollo ni contratar auditorías complejas? Aplicando el comando de verificación directa en la caja de búsqueda habitual de Google:
site:tudominio.com
El resultado de esta consulta arroja un diagnóstico empírico e inmediato:
- Si el sistema te devuelve un listado estructurado de tus URLs: El robot ha procesado tu entorno, ha interpretado tu código y te mantiene presente en sus centros de datos para mostrarte cuando los usuarios hagan consultas relacionadas.
- Si el resultado es una pantalla en blanco o el desierto digital: Significa que existe un bloqueo de acceso severo que impide el tránsito de las arañas de rastreo, como una directiva de bloqueo en el archivo de directivas del servidor o una etiqueta accidental de noindex en las cabeceras.
Otro síntoma crítico que arrojan las auditorías operativas es la denominada «ceguera de contenido corporativo». Esto sucede cuando una organización diseña su interfaz saturándola con imágenes estáticas complejas que contienen los textos, los beneficios del servicio y las ofertas comerciales incrustados dentro del propio archivo gráfico.
El robot de indexación es perfectamente capaz de identificar que existe un archivo de imagen alojado en una ruta determinada, pero no puede interpretar de forma semántica los caracteres tipográficos que contiene su dibujo interno.
Para la máquina, ese bloque es un espacio completamente vacío. Si la esencia operativa de tu negocio reside únicamente en formatos gráficos aislados, para Google eres exactamente igual que un libro técnico con todas las páginas impresas en blanco. Todo contenido estratégico debe redactarse en texto real para existir a ojos del algoritmo.
3. La Metodología: El flujo secuencial de Rastreo, Indexación y Clasificación
Para implementar la lógica de procesos en el posicionamiento orgánico, debemos entender la ingeniería de Google como un flujo de trabajo industrial lineal compuesto por tres fases sucesivas e interdependientes: Rastreo, Indexación y Clasificación (Ranking). Saltarse el entendimiento de este circuito provoca que muchas empresas inviertan recursos en optimizaciones inútiles antes de corregir la base del embudo.
Fase 1: El Rastreo (Crawl)
Constituye la fase de descubrimiento técnico de activos. Google despliega sus arañas informáticas con la misión de saltar de un hipervínculo a otro a lo largo de toda la red global. Si ninguna plataforma externa enlaza tu URL y no te has encargado de facilitarle de forma directa tu mapa de carreteras (el archivo Sitemap XML estructurado), el proceso de rastreo no llegará a iniciarse jamás por falta de señales de entrada. El robot no adivina qué páginas existen; necesita una ruta definida para llegar a ellas.
Fase 2: La Indexación (Index)
Representa el control de calidad, procesamiento y almacenamiento. Una vez que la araña ha descargado los datos y el código HTML de tu página, el sistema central analiza el texto, evalúa su coherencia, descarta el contenido duplicado o de escaso valor y decide si la información posee la relevancia suficiente para ser archivada en sus centros de datos. En este punto, el algoritmo cataloga la temática de tu texto y la posiciona en el estante virtual correspondiente de su gigantesca biblioteca digital. Si una página se rastrea pero no se indexa, jamás aparecerá ante una búsqueda.
Fase 3: La Clasificación (Ranking)
Es la fase de salida y entrega de resultados. Cuando un cliente potencial introduce una consulta concreta en el buscador, Google no rastrea internet en ese milisegundo; consulta su índice previamente clasificado y, aplicando criterios de relevancia semántica, velocidad de carga y autoridad técnica, determina qué páginas merecen ocupar los primeros puestos de la pantalla.
Nuestra metodología se centra en facilitar operativamente estos tres pasos. No buscamos engañar o alterar el algoritmo mediante atajos artificiales, sino convertirnos en la opción más ordenada, limpia y estructurada de la biblioteca. Si consigues que el robot ahorre tiempo y ciclos de computación al leer tu arquitectura, el sistema te recompensará de forma automática con una visibilidad constante y de calidad.
4. La Implementación: Señales de jerarquía semántica y texto alternativo
¿Cómo ejecutamos mejoras de infraestructura en nuestros artículos sin poseer conocimientos de programación ni alterar líneas de código complejas? Utilizando las etiquetas de marcado semántico que el robot emplea para interpretar la jerarquía de la información, gestionándolas directamente desde el panel de edición visual:
- Jerarquía taxonómica de Encabezados (H2, H3, H4): Imagina que tu artículo técnico equivale a la edición impresa de un diario de referencia. El título principal (H1) es la gran noticia de la portada. Los encabezados H2 actúan como los subtítulos estructurados de cada sección operativa, y los H3 o H4 desglosan los puntos específicos de dichos apartados. El robot requiere esta organización taxonómica estricta para comprender el peso de cada idea. Si te limitas a aplicar negritas visuales o a subir el tamaño de la letra de forma manual sobre texto plano, la máquina será completamente incapaz de diferenciar una directriz estratégica de una frase de apoyo.
- Texto Alternativo (Alt Text) en Recursos Gráficos: Dado que el robot carece de visión espacial, utiliza este atributo de texto para decodificar qué representa cada recurso visual. Si incorporas una fotografía o un esquema que ilustra el flujo de trabajo de tu negocio, evita guardarla con nomenclaturas automáticas del tipo IMG_9876.jpg. Implementa un texto alternativo preciso y descriptivo, como por ejemplo: Esquema de trazabilidad operativa para circuitos comerciales en pymes. De este modo, la máquina asimila el recurso y lo suma a la relevancia semántica global del artículo.
La disciplina de aplicar estas etiquetas en cada publicación marca la diferencia entre un portal profesional que escala posiciones y un repositorio desordenado de texto que el buscador no sabe cómo clasificar.
5. Arquitectura de Pasillos: El poder del interlinking estructurado
La tercera acción de implementación obligatoria dentro de la capa digital es el diseño deliberado de una red de Enlaces Internos (Interlinking). Construir conexiones de hipertexto entre tus propios artículos técnicos equivale a diseñar los pasillos interiores, las puertas y las escaleras de comunicación de una sede corporativa.
Al enlazar una temática actual con una explicación previa, le estás indicando al robot de forma explícita: «Si este procedimiento operativo ha resultado de tu interés, dispongo de este otro componente técnico que complementa y aporta valor directo al contexto».
Facilitar el tránsito fluido de las arañas de software a través de tus propios enlaces internos es la estrategia más eficiente y económica para asegurar que el motor indexe la totalidad de tus páginas publicadas, evitando que ningún rincón de tu producción de contenidos quede relegado a zonas de sombra de rastreo (las llamadas páginas huérfanas).
Además de guiar al rastreador, el interlinking estructurado retiene al usuario cualificado dentro de tu ecosistema. Cuando un lector encuentra respuestas encadenadas a sus dudas operativas, su tiempo de permanencia aumenta y navega por múltiples secciones de tu web, transmitiendo a los motores de búsqueda una señal inequívoca de satisfacción y utilidad real.
6. La Adopción: El hábito del control y la optimización del presupuesto de rastreo
La adopción definitiva de este modelo se produce cuando la dirección asimila que la relación operativa con los motores de búsqueda no consiste en una acción técnica aislada que se delega una tarde, sino en una disciplina continua de mantenimiento de infraestructura digital. No aporta valor estratégico ser riguroso durante una semana si abandonas la coherencia del sistema durante el resto del trimestre.
El hábito organizativo fundamental que debes adoptar es la supervisión periódica de Google Search Console. Esta plataforma constituye el único canal de comunicación oficial y directo donde el propio algoritmo te notificará mediante alertas técnicas si ha detectado un cuello de botella, una URL inaccesible, un fallo de redirección o un error de cobertura en tus servidores.
Adoptar esta rutina de control mensual te permite corregir incidentes en las tuberías de datos antes de que se traduzcan en una pérdida de visibilidad en el mercado. Es el equivalente industrial exacto a realizar un mantenimiento predictivo en tu cadena de producción antes de que se produzca una avería mecánica que detenga la fábrica.
Asimismo, adoptar la lógica digital implica defender la simplicidad estructural. A menudo se comete el error de implementar scripts de diseño excesivamente pesados, efectos visuales superfluos o animaciones accesorias que ralentizan la velocidad de carga de la página.
La adopción del SEO lógico te recuerda una máxima de procesos: si un componente puramente estético ralentiza el acceso del robot y consume su presupuesto de rastreo (Crawl Budget) de forma estéril, la decisión más eficiente es eliminarlo del sistema para salvaguardar la velocidad de respuesta.
Google es un motor automatizado que prioriza la eficiencia energética y técnica; si tú le facilitas el ahorro de recursos informáticos en su lectura, él te otorgará la visibilidad que tu negocio necesita para liderar su segmento.

40 Oportunidades en LinkedIn
Guía práctica para optimizar tu presencia, construir autoridad técnica y captar clientes.
Comprar eBook · 3,99 €7. Conclusión: La alianza lógica con el algoritmo
En definitiva, el principal buscador del mercado no opera como un enigma indescifrable ni como un oponente al que hay que tender trampas; constituye un sistema de procesamiento lógico que persigue la optimización de sus recursos de computación y la máxima satisfacción del usuario que realiza consultas.
Cuando decides organizar tu infraestructura digital no para camuflar información o adornar la realidad, sino para hacerla transparente, legible y accesible, estás construyendo un activo patrimonial que ganará valor y solidez con cada semana que pase. Deja los artificios y las metáforas abstractas para otros entornos y utiliza la arquitectura semántica de tu blog para servir con exactitud y solvencia a quienes te buscan en internet.
A nivel personal, siempre he comprobado que tanto en la consultoría de procesos como en la gestión de infraestructuras digitales, el orden y la claridad documental vencen a cualquier atajo temporal.
Cuando tratas la arquitectura de lo que publicas con el mismo rigor técnico que aplicas en las operaciones de tu empresa, el algoritmo deja de ser una incógnita y se convierte en el mejor aliado de distribución para tu negocio.
8. Preguntas Frecuentes
¿Cómo interpreta Google una página web en comparación con un usuario humano?
Un usuario visualiza elementos de diseño, tipografías, colores corporativos y composición estética. Por el contrario, el robot de Google (Googlebot) ignora por completo la apariencia visual y lee exclusivamente el código fuente (HTML estructurado y texto plano), analizando la jerarquía de los encabezados semánticos y la velocidad de respuesta del servidor para catalogar la información.
¿Cuáles son las tres fases del circuito de búsqueda de Google?
El proceso sigue una secuencia estricta e interdependiente:
- Rastreo: los programas automáticos descubren URLs a través de hipervínculos externos o leyendo el Sitemap XML.
- Indexación: se analiza, limpia y archiva el contenido calificado en los centros de datos centrales.
- Clasificación: el algoritmo ordena las páginas indexadas en función de su relevancia, contexto y autoridad técnica cuando un usuario formula una consulta en el buscador.
¿Qué acciones básicas sin código mejoran la lectura de los rastreadores?
Resulta imprescindible utilizar una jerarquía lógica de encabezados (etiquetas H2 y H3 en lugar de párrafos con negrita), asignar descripciones precisas en el texto alternativo (ALT) de todas las imágenes para dotarlas de significado semántico y conectar las publicaciones mediante una red deliberada de enlaces internos que evite páginas aisladas.
¿Por qué es perjudicial incluir texto importante dentro de imágenes?
Porque los rastreadores de búsqueda no interpretan el texto incrustado dentro de un archivo gráfico como información indexable. Si los servicios, ofertas o procesos de tu empresa se publican únicamente como imágenes o carteles diseñados, para el algoritmo esa sección es invisible y equivale a una página completamente vacía.
Te leo en los comentarios 👋